<?php // Полная загрузка сервисных книжек, создан 2026-01-05 12:44:55
global $wpdb2;
global $failure;
global $file_hist;
///// echo '<H2><b>Старт загрузки</b></H2><br>';
$failure=FALSE;
//подключаемся к базе
$wpdb2 = include_once 'connection.php'; ; // подключаемся к MySQL
// если не удалось подключиться, и нужно оборвать PHP с сообщением об этой ошибке
if (!empty($wpdb2->error))
{
///// echo '<H2><b>Ошибка подключения к БД, завершение.</b></H2><br>';
$failure=TRUE;
wp_die( $wpdb2->error );
}
$m_size_file=0;
$m_mtime_file=0;
$m_comment='';
/////проверка существования файлов выгрузки из 1С
////файл выгрузки сервисных книжек
$file_hist = ABSPATH.'/_1c_alfa_exchange/AA_hist.csv';
if (!file_exists($file_hist))
{
///// echo '<H2><b>Файл обмена с сервисными книжками не существует.</b></H2><br>';
$m_comment='Файл обмена с сервисными книжками не существует';
$failure=TRUE;
}
/////инициируем таблицу лога
/////если не существует файла то возврат и ничего не делаем
if ($failure){
///включает защиту от SQL инъекций и данные можно передавать как есть, например: $_GET['foo']
///// echo '<H2><b>Попытка вставить запись в лог таблицу</b></H2><br>';
$insert_fail_zapros=$wpdb2->insert('vin_logs', array('time_stamp'=>time(),'last_mtime_upload'=>$m_mtime_file,'last_size_upload'=>$m_size_file,'comment'=>$m_comment));
wp_die();
///// echo '<H2><b>Возврат в начало.</b></H2><br>';
return $failure;
}
/////проверка лога загрузки, что бы не загружать тоже самое
$masiv_data_file=stat($file_hist); ////передаем в массив свойство файла
$m_size_file=$masiv_data_file[7]; ////получаем размер файла
$m_mtime_file=$masiv_data_file[9]; ////получаем дату модификации файла
////создаем запрос на получение последней удачной загрузки
////выбираем по штампу времени создания (редактирования) файла загрузки AA_hist.csv, $m_mtime_file
///// echo '<H2><b>Размер файла: '.$m_size_file.'</b></H2><br>';
///// echo '<H2><b>Штамп времени файла: '.$m_mtime_file.'</b></H2><br>';
///// echo '<H2><b>Формирование запроса на выборку из лога</b></H2><br>';
////препарируем запрос
$text_zaprosa=$wpdb2->prepare("SELECT * FROM `vin_logs` WHERE `last_mtime_upload` = %s", $m_mtime_file);
$results=$wpdb2->get_results($text_zaprosa);
if ($results)
{ foreach ( $results as $r)
{
////если штамп времени и размер файла совпадают, возврат
if (($r->last_mtime_upload==$m_mtime_file) && ($r->last_size_upload==$m_size_file))
{////echo '<H2><b>Возврат в начало, т.к. найдена запись в логе.</b></H2><br>';
$insert_fail_zapros=$wpdb2->insert('vin_logs', array('time_stamp'=>time(),'last_mtime_upload'=>$m_mtime_file,'last_size_upload'=>$m_size_file,'comment'=>'Загрузка отменена, новых данных нет, т.к. найдена запись в логе.'));
wp_die();
return $failure;
}
}
}
////если данные новые, пишем в лог запись о начале загрузки
/////echo '<H2><b>Попытка вставить запись о начале загрузки в лог таблицу</b></H2><br>';
$insert_fail_zapros=$wpdb2->insert('vin_logs', array('time_stamp'=>time(),'last_mtime_upload'=>0, 'last_size_upload'=>$m_size_file, 'comment'=>'Начало загрузки'));
////очищаем таблицу
$clear_tbl_zap=$wpdb2->prepare("TRUNCATE TABLE %s", 'vin_history');
$clear_tbl_zap_repl=str_replace("'","`",$clear_tbl_zap);
$results=$wpdb2->query($clear_tbl_zap_repl);
///// echo '<H2><b>Очистка таблицы сервисных книжек</b></H2><br>';
if (empty($results))
{
///// echo '<H2><b>Ошибка очистки таблицы книжек, завершение.</b></H2><br>';
//// если очистка не удалась, возврат
$failure=TRUE;
wp_die();
return $failure;
}
////загружаем данные
$table='vin_history'; // Имя таблицы для импорта
//$file_hist Имя CSV файла, откуда берется информация // (путь от корня web-сервера)
$delim=';'; // Разделитель полей в CSV файле
$enclosed='"'; // Кавычки для содержимого полей
$escaped='\



Не применительно к 1С, а вообще, моё ИМХО. InMemory OLTP пока слишком хлопотная и молодая техника, которую имеет смысл применять ОЧЕНЬ точечно: а) она «плывёт» пока от версии к версии, слишком много ограничений, слишком много специфики.
Зато может существенно помочь (если есть возможность принять соответствующие риски). Плюс в том, что можно обойтись вообще без изменений логики. Если у вас основные тормоза на WRITELOG и они не устранимы переконфигурированием структуры хранения, если при этом потеря последних нескольких транзакций несущественна (например, есть возможность снова их прокрутить/перепровести/перезагрузить или бизнес принимает риск потери данных при полном отказе сервера в пару минут — на самом деле для относительно небольших систем это типично). То в этих условиях Delayed Transaction Durability может дать хороший прирост, а главное, без увеличения стоимости сопровождения и без дополнительной разработки. Но, конечно, это не 30-100 раз, как InMemory OLTP.
1с индустрии проблема квалифицированных кадров. всегда 1 вопрос: @а кто будет поддерживать это чудо когда, когда уйдет мега гений».
(2) Именно в InMemory OLTP вопрос даже не в этом. 1С для своих таблиц не предполагает и не поддерживает использование in memory. Как минимум из этого следует необходимость работы прямыми запросами, сложности при реструктуризации и вообще геморрой с обслуживанием и хождение по граблям. Для этих таблиц и native compiled процедур есть гора ограничений:
В общем, если решение не на 1С и есть пара таблиц, которые направшиваются (явное продиагностированное узкое место, которое лечится in-memory OLTP), область общения с этими таблицами ограничена и есть вменяемый DBA, то можно использовать (особенно для промежуточных расчетов).
Короче, мощная, но капризная высокоточная снайперская винтовка, требующая высококлассных специалистов и немалых затрат на обслуживание.
Незаменима для определённого класса задач (например обработка более 1000 событий в секунду и онлайн-аналитика по ним), но для 1С как-то слишком хлопотно.
С другой стороны — за темой in-memory реально будущее. MS SQL Server, SAP Hana, Oracle Database In-Memory — все они прорабатывают эту тему. В in-memory существенно отличаются подходы к обработке данных по сравнению с классическими «дисковыми» РСУБД (активное использование хэш-индексов, колоночных индексов), к обеспечению ACID. До вендоров коробочных массовых решений это доползет лишь через несколько лет.
Из статьи я так и не понял, как выглядит работа с OLTP базой со стороны 1С, нужно подключаться напрямую через ADO и получать данные нативными SQL запросами?
«Горе от ума» (с) Грибоедов.
Написать толковую конфигурацию вместо типовой не пробовали ? Ну хоть раз в жизни ?
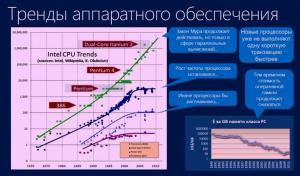
Очень много безмысленных картинок, Тренды шменды. еле дочитал!
(3) speshuric, еще забыл уточнить, прямые запросе ВНЕ 1С это нарушение лицензионного соглашения целестности данных.
(7) logarifm,
Запросы только на запись? Если дамп или копирования таблицы типа справочника(ну пусть номенклатура) в свою сторонню БД средствами SQL сервера не думаю что нарушил. Тут идет чтение и права на уровне БД(потому как то же самое можно регламентным заданием сделать — но увы на больших табличка SQL нативный будет в разы шустрее.
(7) Есть хотябы один пример, когда за это у нарушителей были хоть малейшие проблемы с 1С?
подпишусь
(9) genayo, есть один.
были у софтпоинта проблемы с 1с.
Статья вызвала удивление.
Если мы переносим бизнес-логику на SQL-сервер, то мы вообще-то теряем те самые управляемые блокировки платформы, т.к. они реализованы на уровне сервера приложений.
Потому что бизнес-логика в ряде мест не укладывается в пресловутый Read Committed.
Описанное преимущество «мультиверсионности» и отсутствия необходимости в блокировках не выдерживает критики — СУБД-версионники существуют десятки лет, Read Committed Snapshot для MS SQL поддерживается начиная с 8.3, но когда ты контролируешь остатки, распределяешь партии или взаиморасчеты, концепция «версий» не обеспечивает целостности данных, т.к. недопустимо, чтобы каждый поток видел свою «версию» остатков — здесь бизнес-логика требует видеть реальный остаток именно сейчас. Именно для этого и используются управляемые блокировки, «дополняющие» используемый уровень изоляции СУБД (Да даже в автоматическом режиме с Serializable на регистрах нужно было хинтить for update!).
Показанные замеры с переносом логики в ХП SQL не имеют смысла, если потеряна поддержка управляемых блокировок — потому что очевидно, что при контроле остатков, задержка была именно в ожидании установки блокировки!
Не совсем ясно, как вообще выполняются ХП? откуда берется код? Вот платформа проверяет наличие записей в регистре, проверяет его настройки по метаданным, пишет со сплиттером или без, с учетом разделителя данных в multitanancy и в определенном порядке, добавляет условия RLS,обновляет таблицу итогов — это всё помимо управляемых блокировок. Неужто всё это перенесено на уровень SQL и учтено в замерах?
Ответ на вопрос «директора» есть на ИТС, ИС, Мисте, где угодно, странно видеть это основанием к подобному исследованию.
Смысл статьи в том, что нужно отказаться от 1С в плане реализации бизнес-логики и написать ее на чем-нибудь вменяемом, а в 1С реализовать выгрузку для отчетности регуляторам и, возможно, ведение операций банка и кассы.
1С в принципе не заточена под высокую нагрузку — она просто не умеет. Скорость интерпретатора весьма низкая, эффективность кода на языке никакая, методов оптимизации кода на 1С почти нет — даже утилиты анализа кода на 1С — это редкая штука за какие-то деньги с никаким качеством анализа и минимумом советов по улучшению.