В конторе, в которой я сейчас работаю, возникла необходимость раз в месяц выгружать продажи из Ут в Бухгалтерию. Дело обычное, но проблема заключалась в том, что объем данных оказался приличным (около 500 реализаций в день) и выгрузка/загрузка обычным способом была очень долгой, так что мы решили прибегнуть к некоторым ухищрения, о которых я хочу рассказать в этой публикации, может кому-то они помогут.
По сути, мы имеем 3 этапа, которые я опишу, а так же какой выигрыш по времени мы получили:
Выгрузка данных из УТ (было ~ 45 часов, стало 8 -10)
Загрузка в бухгалтерию (на удивление быстро проходит, но стала идти параллельно с выгрузкой из УТ)
Проведение загруженных документов в бухгалтерии (было 40 часов, стало 10)
Сразу хочу уточнить, что для взаимодействия между базами мы автоматом создавали в папке на сервере файлики (маяки). Это выглядит довольно грубо, но на деле оказалось довольно удобно. Можно посмотреть на каком этапе процесс выгрузки/загрузки, не заходя в базы. Плюс у нас ночью перезагружаются серваки, и если выгрузка/загрузка не успела пройти за вечер по этим маякам видно, на чем дело остановилось.
Так же мы создали 2 константы: начало периода выгрузки и окончание периода выгрузки. Если нам нужно выгрузить март, то устанавливаем 01.03.2014 и 31.03.2014 в соответствующих константах. Выгрузка месяца каждый раз согласовывается с бухгалтерией и день для нее назначается вручную.
Выгрузка
Выгрузка данных из УТ осуществляется с помощью обработки «Универсальный обмен данными в формате XML», которая запускается регламентными заданиями по расписанию. Выгрузка идет в 8 потоков, т.е. параллельно запущены 8 регламентных заданий. Стартуют они с интервалом 1 минута. Выгрузка идет по 1 дню.
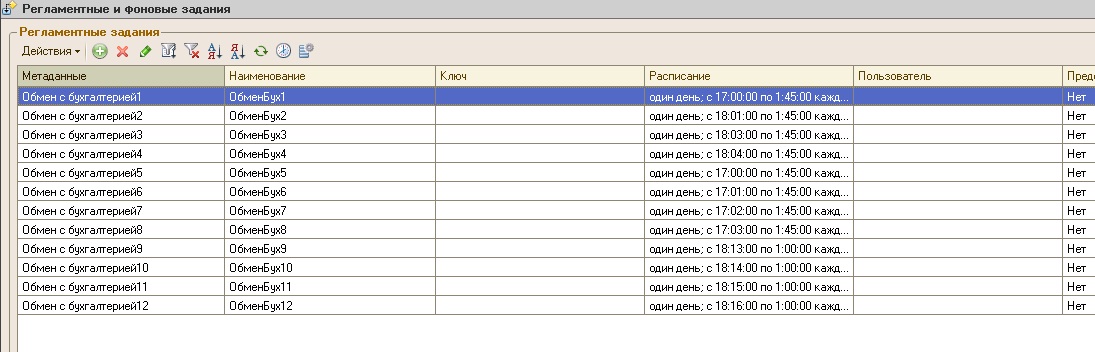
Принцип работы регламентного задания выгрузки.
При запуске задания создается файлик в папке «Начата выгрузка в УТ» имя которого, это дата для выгрузки. Это нужно для того, что бы следующее регламентное задание знало, какой день надо выгружать.
Т.е. например нам надо выгрузить март. Ищем в папке «Начата выгрузка в УТ» файлы и, анализируя каких не хватает, определяем день для выгрузки. Что удобно, если был пропущен день, то он начнет выгружаться.
Функция ПолучитьДеньВыгрузки()
НайденныеФайлы = НайтиФайлы(Путь,"*.txt");
НачалоПериодаВыгрузки = Дата(Формат(Константы.НачалоПериодаВыгрузки.Получить()));
КонецПериодаВыгрузки  = Дата(Формат(Константы.КонецПериодаВыгрузки.Получить()));

Если НачалоПериодаВыгрузки = '00010101' или КонецПериодаВыгрузки = '00010101' Тогда
Сообщить("Константа НачалоПериодаВыгрузки или КонецПериодаВыгрузки не заданы");
Возврат Неопределено
КонецЕсли;
ДеньВыгрузки = НачалоПериодаВыгрузки;
Пока ДеньВыгрузки  0 Тогда
ДеньВыгрузки = ДеньВыгрузки + 24*60*60;
Продолжить
Иначе
Возврат ДеньВыгрузки
КонецЕсли;
КонецЦикла;
Возврат неопределено
КонецФункции
Перед началом выгрузки в папке «Начата выгрузка в УТ» создается файл, имя которого это дата выгружаемого дня. Теперь остальным регламентным заданиям видно, что этот день выгружается или уже выгружен и его не надо трогать.
В папке «Файлы выгрузки» создаются сами файлы с данными. У них тоже имена – это даты. Видно, какой день выгружен. Что интересно, обработка «Универсальный обмен данными в формате XML» увеличивает файлы выгрузки каждые 2-3 секунды, т.е. видно как идет выгрузка. Это тоже бывает полезно.
После окончания выгрузки в папке «Закончена выгрузка из УТ» создается txt файл с именем – датой. Таким образом, появляется возможность определить, какие файлы можно загружать в бухгалтерию.
Так устроена выгрузка в несколько потоков. Работает нормально, задания особо друг другу не мешают. Пробовали выгружать в 4, 8 и 12 потоков. По опыту 30 файлов (месяц) лучше всего выгружать в 8 потоков.
Загрузка
Загрузка в бухгалтерию так же осуществляется регламентным заданием, но только в 1 поток, т.к. по логике считывание данных может происходить одновременно несколькими заданиями, а вот запись нормально без блокировок идет только в 1 поток.
Принцип тут следующий:
В 6 вечера стартует регламентное задание в бухгалтерии с интервалом 10 секунд. В папке «Закончена выгрузка из УТ» ищем файлы и определяем, какой день можно загружать и сразу удаляем это файл. Определив день, ищем соответствующий файл с данными по наименованию и загружаем его. По окончанию создаем файл с именем датой в папке «Загружены в Бух». И теперь видно, какие дни полностью загружены в бухгалтерию.
Выгрузка из УТ и загрузка в бухгалтерию начинается одновременно, поэтому, как только день заканчивает выгружаться, он сразу начинает загружаться в бухгалтерию.
Проведение документов в бухгалтерии
Так как документов много, то решили на время проведения засунуть базу в оперативную память (ram dick). Использовали программу RAMDisk, описывать ее установку я не буду, т.к. занимался этим не я и в интернетах можно найти инструкции.
Документы должны проводиться в строгой последовательности по датам без учета их типа, для этого был нарисован нехитрый запрос.
В результате после загрузки непроведенных документов за месяц, бухгалтерия архивировалась в .dt и разворачивалась в файловой версии в оперативке. После проведения, она снова отправлялась в .dt и разворачивалась на своем законом месте и Вуаля! Мы получаем счастливого бухгалтера. Во всяком случае, я в это верю.
Related Posts
 Получение логина и пароля техподдержки 1С из базы
 Класс для вывода отчета в Excel
 Счет-фактура для УПП
 Библиотека классов для создания внешней компоненты 1С на C#
- Акт об оказании услуг (со скидками) — внешняя печатная форма для Управление торговлей 11.1.10.86
 Прайс-лист с артикулом в отдельной колонке
Спасибо за интересный пример. А вы не пробовали не переносить всю базу на RAMDisk а только временные файлы винды и/или скуля? Потому как выгрузка/загрузка dt, как мне кажется, через некоторое время возможно будет съедать всю экономию на проведении.
(1) не думали в этом направлении. Мне кажется, что это лишь частично увеличит производительность, т.к. чтение данных все еще будет с жесткого диска. Но если база разрастается, то ,возможно, это будет решением.
Если речь только о продажах — целесообразно писать свой обмен, основанный, к примеру, на XDTO. Ибо КД вещь универсальная и малотрудозатратная, но очень медленная.
Некоторые приемы для УТ-БП кажутся странными: использование универсального обмена, файлы-маяки. Может не все стандартные способы использовали?
Надо бы тут провести тестовые замеры производительности между КД и XDTO, что является отличной темой для будущей статьи! 🙂 Ну а если разобраться, то когда на серверах стоят слабенькие процессоры, то какую технологию обмена не используй, всегда будет медленно! 32-разрядная система и этим все сказано!
Тоже предстоит настраивать выгрузку-загрузку. Спасибо. Будем иметь ввиду.
Поразмыслил тут, в принципе, использовать КД или XDTO особого выигрыша в работе не даст. Основная нагрузка ведь идет во время выгрузки и загрузки с дальнейшим проведением. А тут уже все зависит от платформы!
(3) Выгружаются все документы, участвующие в товародвижении и оплатах. Про реализации написал что бы указать примерный объем данных.
(4) Использовали обработку универсального обмена, т.к. у нас совсем переписанная ут 10.1 )
Я бы на вашем месте использовал бы веб сервисы, вот есть прекрасная статья, скорость очень высокая.
Lenten, регистрацию изменений используете? Количество объектов в транзакции ограничиваете?
Ещё как вариант можно попробовать справочники выгружать первым этапом, а потом документы, в которых будут выгружаться только ссылки, а не все подчиненные объекты. Это позволит за один запрос получать все необходимые данные для выгрузки без лишних запросов данных к базе. Для интереса посмотрите сколько раз встречается в файле XML идентификатор (или код) какой-нибудь часто используемой номенклатуры.
(10) Спасибо, надо будет ознакомиться.
(11) Если надо будет еще подсократить время, проверим и это
(11) Боюсь что регистрация изменения может дать обратный эффект, ибо дурацкая таблица изменений на которую нельзя наложить блокировку, и которая мешает параллельной работе, может сыграть злую шутку.
Поясню что я имею ввиду. Каждый раз, когда пользователь меняет (записывает) документ программа регистрирует изменения, т.е. пишет в некую таблицу ссылку на записанный объект. И если для документа мы можем настроить управляемые блокировки (т.е. заставить одновременно и параллельно проводить реализации по разным складам), то с таблицей изменений такой фокус не пройдет. Она общая, что приводит нас к двум вещам
1. запись объектов в УТ будет происходить медленнее (так как нужно дополнительно еще писать в таблицу изменении)
2. запись объектов в УТ нельзя распараллелить, ибо пока пишутся изменении, другие объекты в эту таблицу не смогут писать
Второй очень важный момент. Это выгрузка изменений.
Каждый раз при выгрузки программа записывает в таблицу изменений признак того что данный объект был выгружен, добавим сюда тот факт, что на таблицу нельзя повесить управляемую блокировку получаем очень забавную вещь
Регламентное задание 1 начало выгрузку за определенную дату. При выгрузки программа «помечает» в таблицу, что объект выгружен, блокирую таблицу от изменений
Параллельно регламентное задание 2 тоже начало выгрузку, но (!) таблица изменений заблокирована 1 регламентным заданием, и поэтому периодически одно из заданий будет нарываться на ошибку транзакции. Т.е. в этом случае мы не сможем распараллелить выгрузку
Резюме. Положа хвост на сердце. а так ли нам нужна эта таблица изменений? Ну зафиксируем что кто-то записал документ от 2012 года и что? Мы же всё равно его выгружать не будем, нам главное выгрузить все документы за указанный период, и даже если есть изменения за другие периоды нам это не интересно, к тому же есть опасность, что кто-то случайно внесет изменения в бухгалтерию в выгруженные документы и в случае использования регистрации мы получим расхождения (так как в УТ этот документ не помечен как измененный, а значит ни будет не выгружен из УТ, ни обновлен в БП), что в случае выгрузки за период не важно, так как гарантированно что все документы за период в БП будут совпадать с данными в УТ
А по поводу отслеживания изменений… У себя я при выгрузке сделал возможность выгружать обороты и при загрузки в БП программа сравнивает данные из БП и данные из УТ и выдает таблицу расхождений. Т.е. если у бухгалтера есть подозрения, или он хочет проверить что данные актуальны ему достаточно выгрузить данные за период (контрагент, номер документа, дата, сумма — этих данных вполне достаточно чтобы оценить есть ли расхождения. Понятно что от замена номенклатуры в ТЧ она не спасет, но от изменения цены или строк, т.е. изменения суммы документа вполне может выявить). Таким образом бухгалтер может быть уверен в актуальности данных
(13) У нас этот вопрос решился управленчиским методом. Старые месяца наглухо закрывают и все изменения только после согласования с главбухом
Ммм, а для чего «изобрели» фоновый обмен? Более того на эту тему есть хорошая статейка
(16) Не очень понял ваш комментарий. Мы настраивали выгрузку таким образом, что бы выгружать в несколько потоков для ускорения. А в статье написано как сделать обмен в 1 поток.
(17) фоновый обмен как раз и создан для тех случаев, когда зарегистрировано большое количество объектов: задается количество объектов в транзакции и при каждом обмене выгружается лишь указанная часть. А в статье написано, как все это дело еще и автоматизировать
(18) он быстрее чем в описанном мною? за счет чего?
(19) так откуда же мне знать, будет ли это быстрее, я физически не могу смоделировать ваши условия (ведения баз, конфигурацию «железа», работу ОС и т.д.). Но постоянно выгружая объекты в фоновом режиме (например, раз 5 в день по 100 документов), вы получаете оперативную информацию в бухне. И не факт, что общее время выгрузки в фоновом режиме будет больше, чем общее время работы ваших 8 регламентных заданий, к тому же параллельных. Помещение базы в оперативку — да, несомненно даст прирост скорости
(20) Согласен. Когда мы приступали к этому обмену, я предлагал каждый вечер выгружать документы за день, а также измененные документы предыдущих дней вечером. Был бы вполне сносный объем данных, и не пришлось бы заморачиваться. Но в компании работа устроена так, что надо было выгружать месяц (манагеры активно работают с документами за текущий месяц, потом бухи его наглухо закрывают для изменений, и все недоделки менеджеры переносят на новый месяц).
(21) очень многие так делают, а потом ночами все это правят (хорошо, если ошибок не наделали в УТ и все красиво перенеслось, что я редко наблюдал))) А уж когда приходит время сдавать отчетность — вообще караул.
(0) 500 реализаций 45 часов? Как-то совсем медленно, даже для типовой…
(23) там 500 реализаций в день (500 * 30) и еще сопутствующие документы (поступления, платежки и т.д.). Про реализации написал, чтоб показать примерный объем данных
(24) Ну нормально.. Штатный обмен, 12 часов, на на объеме 40 000 документов.
почему так долго загружается? не могу представить себе количество документов, которое бы грузилось 48 часов!
почему нельзя просто первым шагом:
1.загрузить документы — сохранить. (1 ночь)
2.потом частично проводить их — 2-3 ночи если на то пошло…
все равно много…. у вас с сетью проблемы скорее всего — если клиентом грузите, а не напрямую на сервере.
(26)Из статьи
не понял что вы имеете ввиду
Чуть не в тему, но все таки поделюсь своим опытом ниже-процитированного:
Есть нульсовая железяка:
— Xeon CPU E5-2609 v2 2.5GHz (две шт.)
— оперативы 64 гига
— 4 винта в двух RAID 1
Все под Windows Server 2012 R2 (x64)
В качестве исходной базы, брался *.CD размеров 5 гигов. Тестились рам диски двух производителей:
— QSoft (WinRamTech) RAMDisk, о котором говорил ТС,
— SoftPerfect RAM Disk.
Объем диска ставился в 15 гигов.
К моему ужасному расстройству, деградация производительности по перепроведению базы, на вскидку была в раз 10, если сравнивать с тем жестким массивом, о котором я писал. Полагаю, что возможно есть какая-то особенность у 2012 сервера, какая-нибудь волшебная галка, или в самих этих рам дисках, что-то нужно более тонко подстраивать. Повозившись пару дней, бросили эту затею. Поэтому, хотел бы у коллег поспрашать — кто-то сталкивался с подобным?
(28) Единственное что приходит в голову, какие-то используемые файлы остались на жестком диске. Мы пробовали 3 компа, на всех было быстрее чем обычно. В основном это зависело от частоты процессора и частоты оперативной памяти.
(26) aximo, (27) ну имел в виду, видимо, что не верит приведенным цифрам)))
(48 часов*3600сек)/15000 документов~12 сек на загрузку и проведение одного документа
Ну если в файле обмена десяток документов, в тч которых десяток строк, то да, много. Однако, если в файле 15 000 доков и, не зная сколько строк в каждом из них, я бы так сразу и не сказал, что много: тут хотя бы на таком объеме потестировать, как изменяется среднее время на проведение 1 документа, в зависимости от их общего количества (а то может и есть подобные исследования?)))
(30) Я уже писал, примерно 15000 реализаций + сопутствующие документы. файлы xml за месяц весят 773 мб (это за июнь). Я честно никого не обманываю насчет объемов и сроков выгрузки/загрузки ) Если у вас идет все быстрее, то это здорово. Я надеялся акцентировать внимание на методах ускорения, а не конкретных цифрах.
12 сек на загрузку и проведение одного документа — да удавиться…
используйте программное кеширование найденных объектов дабы не искать повторно.
не используйте универсальных тормозных механизмов — напишите свой частный обмен. будет леатать существенно быстрее.
а зачем столько данных переносить? нельзя настроить менее громоздкую выгрузку??
собственно к вопросу — зачем данные о торговом товародвижении в бухгалтерии??
(29)
А саму платформу вы откуда запускали? С этого же RAM диска? Или с дискового массива? Кажется, что сама платформа то пофик должна откуда запускаться. А остальные используемые файлы…был сделан диск H: и на него скопирован *.cd. С дискового массива запущена платформа. Деградация.
А еще вопрос — а какая ОС использовалась у вас?
(34) Все было на виртуальном диске. И платформа и база (файловая). Использовали Windows 7
(32) Раза 4 уже отвечал. Видимо это бесполезно.
(33) Для того, что бы отчитываться перед государством. + руководство просило наиболее детализованные данные для анализа работы менеджеров. Я так понял нужна связка ЗП + продажи. В УТ ведь про зарплату ничего нет.
(32) CheBurator, вы хоть читали собственно публикацию?) Автор как раз и пишет, что штатными средствами выгрузка столько шла, теперь же эти 15 000 доков в бухне грузятся (данные публикации) примерно 10 часов, или (10 часов*3600 сек)/15000доков=2.4 сек на загрузку и проведение одного документа.
(31) да я, собственно, вас ни в ем не обвиняю) Самому стало интересно, как будет увеличиваться среднее время проведения одного документа в зависимости от их общего количества, и в принципе какие программные нюансы будут на это влиять (например, действия самой платформы, кэширование данных и т.п.)