
С чего начать? Во-первых, нужно понимать, что в результате этой операции в наших базах появится третья сущность – некая область данных обмена, которая будет представлять единое целое, расположенное в исходных базах и эта область должна восприниматься именно как нечто единое и неделимое, живущее по своим законам, но при этом остающееся неотъемлемой частью исходных баз. Есть и другое видение – когда получившуюся в результате внедрения обмена систему баз считают как бы одной большой распределенной базой – здесь все зависит от контекста задачи и объема обмениваемых данных. Во-вторых, необходимо выработать правила дальнейшего добавления синхронизируемой информации уже с учетом новых реалий. То ли это будет единое место ввода, то ли будут использоваться префиксы и т.д.
Рассмотрим конкретный пример, который мне довелось решить на практике. А практика, как известно, критерий истины! Немного предыстории. На одном производственном предприятии, территориально находящемся в российской глубинке, изначально учет велся в БП и на начальном этапе развития это всех устраивало. Потом, когда первоначальные цели были достигнуты – производство вышло на некоторый «взрослый» уровень, было решено внедрить в качестве управленческой системы УПП, а БП оставить для сдачи регламентированной отчетности. Всё вести в УПП руководство сочло рискованным, в том числе и по причине отсутствия квалифицированных бухгалтеров в радиусе 100 км вокруг предприятия (все кого удалось найти, уже работали на нем). Изначально внедрять УПП начали силами местной бухгалтерии, которая, недолго думая и поучившись на простеньких курсах в областном центре, начала руками вбивать исходные данные в пустую базу УПП. Через некоторое время (примерно через год по рассказам), так и не дождавшись внятных результатов, руководство предприятия решило все таки передать вопрос внедрения УПП специалисту (вашему покорному слуге – тогда сотруднику управляющей компании), а бухгалтерию разжаловать в разряд вспомогательных сил, то есть, по сути отстранить от непосредственного участия в проекте, на что бухгалтерия естественно обиделась (что впоследствии не раз аукнулось, но не об этом сейчас речь). То есть, УПП нужно было внедрить независимо и обособленно как чисто управленческую программу, и ни о каком обмене данными естественно никто не задумывался. Но, как известно, аппетит приходит во время еды. Достигнув определенных результатов во внедрении УПП (сам процесс внедрения заслуживает отдельного повествования), я получил задачу настроить обмен данными между базами УПП и БП, чтобы исключить дублирование ввода информации. А именно — решено было поступления материалов и отгрузки готовой продукции загружать в УПП из БП (ввод этих весьма ответственных операций на самом деле просто некому было доверить, а бухгалтерия наотрез отказалась касаться УПП, поставив руководство перед выбором – мы или УПП! – бред конечно, но бывает и такое:). Но, как я уже говорил, база изначально создавалась независимо от БП путем ручного ввода и досталась мне в наследство от бухгалтеров (кстати сказать, я об этом и не подозревал сначала – все эти подробности выяснились уже позже, а отступать было некуда, сказано — сделано). На этом предысторию я заканчиваю.
Итак, предстояло сделать следующее:
- Определить круг объектов, подлежащих синхронизации
- Выбрать метод синхронизации
- Определить базу, в которой будет производиться изменение ключевой для синхронизации информации
- В зависимости от выбранного метода синхронизации, изменить ключевые данные синхронизации в выбранной базе
Сами правила обмена были разработаны в кратчайшие сроки без каких-то проблем (их здесь не публикую, так как они нагружены некоторой не универсальной спецификой), так как конфигурации УПП и БП очень близки по структуре (ничего готового тогда не нашел).
Далее по пунктам.
- Объекты. Справочник «Номенклатура», подчиненные ему справочники «Единицы измерения» и т.д., справочник «Контрагенты» с подчиненными ему справочниками «Договоры контрагентов» и пр.
- Выбор метода синхронизации – «По внутреннему идентификатору». В силу разных причин для меня это самый привычный и предпочтительный метод синхронизации.
- В качестве базы, в которой будет произведена корректировка ключевой информации была выбрана УПП (ее размер был тогда меньше, да и ничего другого в силу изложенного выше было не дано и в общем не нужно).
- Вопрос синхронизации данных был решен в несколько этапов:
4.1 Из БП были выгружены данные нужных нам справочников — код, наименование, код владельца и наименование владельца.
4.2 В УПП были найдены все соответствующие элементы, которым были установлены такие же коды и наименования, как в БП – все это было аккуратно проделано вручную без использования каких либо средств автоматизации. Объемы работ были вменяемыми – мне повезло. Если бы понадобилось что-то придумывать, я бы скорей всего использовал нечеткий поиск на базе сравнения строк (//infostart.ru/public/146559/).
4.3 Дальше я применил следующий метод. Основываясь на том, что данные в двух базах вводились независимо, то есть уникальные идентификаторы объектов у всех разные и поэтому, получив таблицу замен уникальных идентификаторов: «UID в БП» – «UID в УПП», их можно заменять в XML — файле выгрузки базы просто как текст, не вникая в подробности (тип данных, структура самого файла XML и пр.), что и было проделано. Кстати сказать, свойство «вселенской» уникальности UIDов не раз меня выручало в различных задачах – выражаясь образно, его всегда можно «бросить» в некую «кучу», а потом легко найти там же простыми средствами (банальный перебор или еще что то — по ситуации).
То есть:
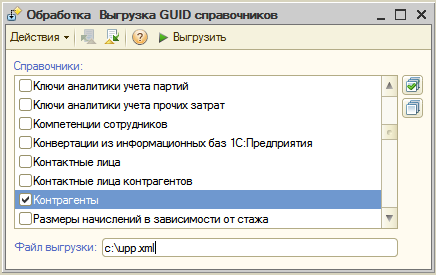
4.3.1 С помощью обработки «ВыгрузкаGUID_Справочников» (есть во вложении) были сформированы 2 файла с данными справочников (код, наименование, код владельца, наименование владельнца и UID) для каждой из баз.
4.3.2 Данные из базы УПП с помощью встроенной обработки обмена между одинаковыми базами были выгружены в файл. Можно было так же использовать универсальную обработку обмена данными между одинаковыми конфигурациями с диска ИТС или механизм создания подчиненного узла РИБ (потом главный узел отключить и удалить узлы).
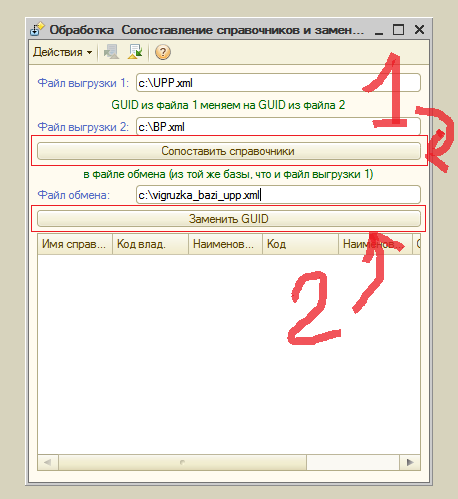
4.3.3 С помощью обработки «СопоставлениеСправочниковИЗаменаGUID» (есть во вложении), в файле выгрузки, путем перебора строк файла выгрузки базы как обычного текстового файла, произведены замены UIDов по данным выгруженных из баз файов с данными справочников (п. 4.3.1).
4.3.4 Данные обработанного таким образом файла выгрузки загружены в пустую базу УПП, созданную из конфигурации исходной.
В результате были получены базы, готовые обмениваться необходимыми мне данными.
Дальше в ходе работы конечно же всплывали некоторые единичные косячки, которые точечно устранялись универсальной обработкой замены ссылок.
Во вложении архив с использованными мной обработками (все как есть), которые могут пригодится в подобной ситуации и подойдут для любой конфигурации. Конечно, все это может показаться слишком сложным, но тем и интересно.
Надеюсь, мой опыт кому-нибудь пригодится!
P.S.
Для умников. Зачем я это пишу? Отчасти графомания, отчасти от скуки и все же не исключаю, что кому то это будет интересно 🙂
Related Posts
 Получение логина и пароля техподдержки 1С из базы
 Класс для вывода отчета в Excel
 Счет-фактура для УПП
 Библиотека классов для создания внешней компоненты 1С на C#
- Акт об оказании услуг (со скидками) — внешняя печатная форма для Управление торговлей 11.1.10.86
 Прайс-лист с артикулом в отдельной колонке
Приблизительно такую идею использовала при разовых задачах, заменяя UID вручную в файлах обмена.
Хотелось бы уточнить следующий момент —
Какой алгоритм, точнее принцип формирования этого файла?
Я правильно поняла, что именно для этого предварительно и выполнялись эти пункты:
4.2 В УПП были найдены все соответствующие элементы, которым были установлены такие же коды и наименования, как в БП – все это было аккуратно проделано вручную без использования каких либо средств автоматизации. Объемы работ были вменяемыми – мне повезло. Если бы понадобилось что-то придумывать, я бы скорей всего использовал нечеткий поиск на базе сравнения строк (.
А далее, выполнив эту работу в двух базах и сравнив в обработке значения реквизитов справочников, получили соответствия UID?
(1) ula1c, спасибо за вопрос! Исправил некоторые неточности в описании и добавил скриншоты. Принцип очень простой — так как наименования и коды элементов наших справочников уже совпадают, названия самих справочников тоже совпадают (УПП и БП все таки), то вариант ищем по простому совпадению полей в одинаковых справочниках. Кстати делалось все это в далеком 2011 году. Сейчас бы я сделал уже по другому наверное — с помощью конвертации, в которой сначала включил бы синхронизацию по код+наименование и перегнал бы UIDы в УПП… Но все таки здесь самым главным является момент с заменой UIDов в файле полной выгрузки бызы. Будут вопросы — стучитесь в личку )
(2) спасибо за разъяснение. Пока вопросы были чисто теоретические, для понимания и усвоения принципа вашей идеи, для багажа, так сказать.
Огромное Спасибо,
очень было интерсно почитать полностью всю статью,
для общего развития, что и такое возможно.
Опечатку в заголовке публикации поправьте 🙂
(4) АлексейН, Спасибо! Рад )
(5) echo77, спасибо, поправил )
С уидами заморачиваться это конечно весело, но после приведения в соответствие кодов следовало вставить в конвертацию данных синхронизацию по коду и на этом покончить с вопросом синхронизации затратив времени в два раза меньше. После чего получить за это деньги с клиента и заниматься новым проектом. Клиенту, поверьте, все равно как вы синхронизируете: по GUIDу, по коду или по лунному календарю. Качество не пострадает. Разве только чуть увеличится время обмена, но могу предположить, что в вашем случае это не критично вовсе. Однако, ваши обработки могут пригодиться в случае восстановления побитой базы и за это спасибо.
(8) Oleg_nsk, синхронизация по коду крайне ненадежная вещь и уверен, что Вам это хорошо известно. Здесь несколько другой подход. Заказчикам действительно все равно как достигнут результат, но лишь тогда, когда они вам доверяют!!! И поэтому, все это в первую очередь нужно мне. К слову сказать, я до сих пор курирую этот проект (люди просто звонят и советуются, как лучше поступить в той или иной новой ситуации), давно занимаясь другими интересными вещами. Но там все сделано надежно и я спокоен. Спасибо за отзыв!
Мир этому дому!
Всегда приятно читать статьи основанные на личном опыте. В комментариях возникают дополнительные альтернативные варианты решения вопросов.Автору плюс.
(9) А в чем ненадежность синхронизации по коду позвольте спросить? Я так понял что номенклатура заводится только в одной базе. Во второй пользователям запрещается изменять номенклатуру вообще. Однако, если запрет был нарушен и во второй базе номенклатуру все же создали, то ее можно будет легко синхронизировать изменив код. А вот в случае ГУИДа так же просто привести элементы справочника в соответствие не получится. Мне приходилось много много раз писать разные обмены и синхронизация по коду показывает высокую степень надежности. А что касается того что с вами советуются, то это уж точно не из-за ГУИДов а из-за дефицита профессиональных и честных разработчиков (надеюсь вы как раз такой), готовых отвечать на вопросы зачастую некомпетентных пользователей. Извините, но на мой взгляд, ваш вариант синхронизации избыточен и может быть оправдан только в целях саморазвития.
Спасибо за статью. Как раз возникла необходимость привести справочник номенклатуры в порядок, имею 11 комплектов УТ-БП и 4 Розницы, все связаны обменами и синхронизация номенклатуры — если не найден элемент по GUID, то по ищется коду и родителю. Сейчас добавилась еще одна база, добавились новые правила и некогда налаженный обмен начал давать сбои, номенклатура начала двоиться. По GUID не находит, а продолжение поиска по коду и родителю не всегда срабатывает. И возникает такой же элемент номенклатуры с таким же кодом. Предполагаю, связано это с разными версиями обработок универсального обмена в разных конфигурациях. Пару дней назад возникла мысль синхронизировать во всех базах GUID. А тут и статья с обработкой. Жирный плюс!
Прочитал статью — задался вопросом: а затем замена гуида, если проще выгрузить сразу из Бухгалтерии в новую УПП и указать в конвертации Продолжить поиск по полям поиска. Но в комментарии 2 пояснено.
(11) Oleg_nsk,не только в одной базе. По поводу избыточности возможно Вы правы, но это именно то, что мне нужно. В «базисных» вопросах, таких как обмен данными, я всегда предпочту некоторую избыточность. Саморазвитие на задачах клиента — здесь тоже может быть несколько другой подход. Опять же возможна ситуация, когда тебе доверяют весь вопрос ИТ или 1С или некоторый участок «в целом» и компания заинтересована в том числе в твоем саморазвитии.
(12) overdriver, рад если пригодилась, спасибо, успехов!
Спасибо за публикацию. В перспективе стоит решение примерно такой же задачи.
GUID уникален только в пределах одной базы. Лично сам натыкался на случай, когда один и тот же GUID представлял разные объекты в двух базах. Так что с уникальным идентификатором, могут возникать неприятные сюрпризы…
(17) Yimaida, в моем случае данные в исходных базах вводились независимо вручную, так что такая вероятность конечно присутствует исходя из самого принципа формирования GUIDа, но крайне мала и если Вы наткнулись, то Вам либо очень крупно «повезло», либо чего то не учли я думаю. Приведу цитату из Википедии:»Хотя уникальность каждого отдельного GUID не гарантируется, общее количество уникальных ключей настолько велико (2128 или 3,4028×1038), что вероятность того, что в мире будут независимо сгенерированы два совпадающих ключа, крайне мала. Тем не менее на системе Windows’95 GUID идентификаторы закладки свойств для ярлыка запуска DOS программ(.pif) и программы Zip Magic совпадали.» В базах 1С одинаковые GUIDы могут встретиться и в одной базе, когда, например, соответствующие объекты созданы загрузкой данных и один объект источника выгружается сразу в несколько объектов приемника, при этом они будут равны GUID источника (метод синхронизации естественно по уникальному идентификатору). Более подробно об этом можно посмотреть здесь кому интересно:
(10) LexSeIch, Спасибо!
(16) gull22, Спасибо, успехов!
адекватная штука =))) делал примерно по такой же системе/, но разово и не стал оформлять как обработину =))
мда. Использовать специально предназначенный типовой РС СоответствиеОбъектовДляОбмена видимо религия велосипедиста не позволяет. Синхронизация делается в разы проще. Незачет вобщем.
Что мешало выгрузить все справочники из БП в УПП, а потом заменить и удалить дубли?
+ а если были настроены обмены и выгрузки в другие базы? А вы махом взяли и заменили гуиды в базе. И получаем дубли в остальных базах, синхронизирующихся по гуидам. Франч такой франч.
(24) Stim213, а если не было других баз? Не вижу смысла конвертировать гуиды при выгрузке, лучше раз заменить почистить и спать спокойно. На перспективу лучше держать гуиды одинаковыми, а то потом взбредет еще какой нибудь обмен делать, вот тогда уже переделывать будет тяжелее.
(23) Aleksey.z, +, Альтернативный рабочий вариант, который я тогда рассматривал. Но выбрал описанный в статье варинат — оптимизировал время простоя базы, который составил несколько часов.
(18) Цитирую Ваш текст: «Кстати сказать, свойство «вселенской» уникальности UIDов не раз меня выручало в различных задачах». Так вот… я в своей практике имел случай когда UUID повторялся, что меня не меньше удивило. Вы же в своей статье не то что в пределах базы уникальность UUID не оговариваете, так и усиливаете его до «вселенского». Я поделился личным опытом, а не статьями с вики, что для меня гораздо ценнее. И привел я свой опыт не в пику Вам, а как очень важное замечание, которое надо иметь в виду.
(24) Stim213,
))) Нет, не франч.
(27) Yimaida, спасибо, буду иметь ввиду на будущее, но я тоже не в пику — нормальная рабочая дискуссия я думаю ) Кстати, Вы абсолютно правы — приведенная цитата лишь дает общее представление о GUID как таковом и я исхожу из того, что ветку читаем не только мы с Вами. На практике все может отличаться от общей теории и в подтверждение этого приведу ссылку на еще одну публикацию — получение времени создания ссылки, чтобы собрать здесь максимум полезной информации по этому вопросу:
(29) согласен. Нормальная рабочая дискуссия. Каких так не хватает на инфостарте 🙂
(25) Aleksey.z, на перспективу — лучше использовать типовые проверенные средства, предназначенные разработчиками как раз для решения подобных задач.
Изобретение велосипедов оно конешн полезно — с точки зрения получения опыта, но не годится для повышения квалификации как специалиста. Знание типовых механизмов позволяет выполнять задачи с гораздо меньшими трудозатратами, и с не меньшей эффективностью.
(28) франч — это не только место работы, это еще и стиль подхода к решению задач. И от этого нужно избавляться по возможности.
Многие вещи в типовых конфигурациях можно сделать
без топора и кувалдыбез программирования(31) Stim213, Какой с вашей точки зрения должен быть типовой вариант проверенный проф. в ситуации как у автора?
Чем плох вариант с переносом справочников и дальнейшей обработкой «ПоискИЗаменаДублирующихсяЭлементов.epf», «ПоискИЗаменаЗначений.epf» хотя бы по ключевым элементам Организации, Валюты, различные классификаторы и т.д. Впрочем если вам предпочтительней поиметь геморрой с регистром СоответствиеОбъектовДляОбмена или промежуточным звеном которое конвертирует гуиды то дело ваше.
(32) Stim213,
ну это философский вопрос, Вам наверное просто не повезло.
(33) Aleksey.z, если наиболее простое решение для вас геморрой и вы не ищете легких надежных путей — мне остается только посочувствовать вам и вашим клиентам.
(34) ок, давайте по конкретике.
Работу вы проделали немалую, сложную и, несомненно, интересную.
Возможно, вы даже знали про РС СоответствиеОбъектовДляОбмена и не стали его использовать по каким-то причинам.
Если не знали — ничего страшного. Если знали, но все равно не стали использовать — прошу вас назвать эти причины, чтобы наше обсуждение было более конструктивным.
(35) Stim213, Сопоставление по гуид самый простой, технологически надежный и легкий способ синхронизации данных, все остальное геморрой но для клиентов и в будущем поэтому прекрасно вас понимаю. Засим данную полемику считаю пустой тратой времени.
(35) Stim213, Вот что действительно вызывает сочувствие, так это Ваша манера излагать свои мысли. Ваша идея тем не менее понятна и это действительно геморрой.
(37) Aleksey.z, как раз для клиентов возможность ручного редактирования настроек синхронизации в регистре была бы удобнее, чем постоянные обращения к программисту. Цель автоматизации — дать клиенту максимум настроек, чтобы он настраивал учет так, как ему надо. Если он захочет, чтобы номенклатура из БП загружалась в другую номенклатуру УПП, он просто изменит запись в регистре и ему не надо будет тратить ресурсы программиста.
Интересно.
было интересно почитать, я думаю ваш опыт пригодится
спасибо и за статью и за полемику в обсуждениях)
Да с каждым днем способов обмена все больше, так что есть с чего выбирать.
(31) Stim213,
Изобретение велосипедов оно конешн полезно — с точки зрения получения опыта, но не годится для повышения квалификации как специалиста. Знание типовых механизмов позволяет выполнять задачи с гораздо меньшими трудозатратами, и с не меньшей эффективностью.
Подскажите, пож-та, где описана методика типовых обменов? или предложите адекватный способ получения этих знаний? догадываюсь, что напишите об отладчике … 🙁
Откуда такая нелюбовь к франчам? Представьтесь, пож-та 🙂
И вообще франч — это форма организации бизнеса (по аналогии с ООО, ЗАО, ИП), а не признак качества, чтобы так судить о решении задачи.
(39) Stim213,
Мой опыт показывает другое: максимум настроек «можно», если у них есть свой программист, который будет в этом копаться, иначе все равно сам будешь настраивать-перенастраивать.
Конкретики от автора так и не дождался. Печально.
(44) Rustig,
В подавляющем большинстве эта форма организации бизнеса заинтересована в получении максимальной прибыли от клиента. И если по поводу квалификации кадров можно спорить долго, то по поводу выполнения задач в большинстве случаев подход одинаков — сделать как можно больше, затратить как можно больше часов, содрать с клиента как можно больше денег. Если доработки чуть сложнее, чем поставить где-то галочку, то франч обязательно будет писать своего монстра, чем пытаться использовать штатные механизмы.
Это вобщем-то обычные рыночные взаимоотношения, но такой подход не годится на фикси.
Очень интересно.
Насколько мне известно, 1С гарантирует уникльность GUIDов только внутри одной таблицы (8.1.15.41)
Однажды сливал две базы в одну и было такое, что один и тот же GUID был в одной базе в разных справочниках.
(49) servs, да, Вы правы. В (18) об этом уже шла речь, то есть одинаковые GUIDы могут быть в одной базе но в разных таблицах и это норамальная ситуация. В принципе и в таком случае можно заменять GUIDы описанным способом, так как при обмене данными помимо GUIDа передается имя таблицы (объекта метаданных).
(45) Rustig, Абсолютно верно. В том числе и то, что максимум настроек может пригодиться и тебе самому. Только вот назвать РС СоответствиеОбъектовДляОбмена пользовательской настройкой язык не поворачивается. Это скорее инструмент для программиста. Самому он мне правда пока не пригодился. Обычно только подчищаю его перед поиском и заменой значений объектов, которые участвуют в к.-л. плане обмена.
лет 10 назад реализовали выгрузку из ТиС 77 в бух.77. В базе источнике ТиС — UID присваивался документам и справочникам, последний номер писали в соответствующую константу. Приемник бухгалтерия его просто получал при обмене. Работало супер.
(11) Видел, как в боевой базе УПП выполнили перенумерацию справочника номенклатуры. Естественно после такого поиск по коду ничего не найдет.
(53) echo77,Запретить изменять нумерацию пользователям гораздо проще, нежели впаривать клиенту несколько лишних часов работы для подобного рода фундаментальных научно-исследовательских работ.
(54) Согласен, проще. Только когда момент упустили и уже насоздавали номенклатуры с «неправильными» номерами от перенумерации было не уйти
(9) (11) у кодов в разных базах может быть разный префикс и тогда вообще никаких проблем. ПО коду проще, чем по гуид.