


Внутри архива *.xlsx практический интерес для получения значений ячеек представляют три вида файлов:
1. workbook.xml — содержит описание рабочей книги (количество листов)
2. sharedStrings.xml — содержит строковые значения ячеек всех листов
3. Файлы sheet1.xml…sheetN.xml — значения ячеек конкретного (по номеру, независимо от названия) листа.
Почти все значения внутри файлов sheet1.xml…sheetN.xml представляют собой числа, причем для строчных значений это индекс строки из файла sharedStrings.xml, а для даты — число дней с начала XX века.
Теги f содержат написание формулы, теги v — значение ячейки, независимо от того было ли оно «вбито» напрямую, или это результат формулы.
Данная обработка исключительно средствами 1С 8.2 производит распаковку архива *.xlsx и парсинг вышеуказанных файлов.
14.06.12
Заодно уж добавил и docxreader
Related Posts
 Получение логина и пароля техподдержки 1С из базы
 Класс для вывода отчета в Excel
 Счет-фактура для УПП
 Библиотека классов для создания внешней компоненты 1С на C#
- Акт об оказании услуг (со скидками) — внешняя печатная форма для Управление торговлей 11.1.10.86
 Прайс-лист с артикулом в отдельной колонке
а формулы считает?
(1) anton.fly7,
формулы без проблем, только я не посчитал нужным их сами выводить, всё равно ж, в основном, значения нужны.
<c r=»B4″>
<f>SUM(B1:B3)</f>
<v>10920</v>
</c>
Тег f — формула, тег v — значение. Лично меня сама формула не интересует
ага, сам примерно такое делал, только для ods (OpenOffice) — там тоже зип-архив, а внутриях хмл, который также можно распарсить
зачетно, для формул нужно очень
Автор, пиши ещё!
Любопытно а какая скорость то чтения, есть какое-то сравнение? Например чтением через тот-же КОМ-Эксель?
(6) по сравнению с КОМ-Эксель, думаю, на порядок
А чем отличается от ?
(8) кхм… наверное тем, что я не мониторю все обработки :)))
В смысле, мы с Василием всегда плюсы друг-другу ставили, но никогда даже и не смотрели, что там за разработки 😉
Эту либо вообще не видел, либо в упор не помню
(6) CaSH_2004,
Проверял на матрице 10 000 строк х 5 колонок, ровно 7 секунд на моем рабочем
(Intel® Core™2 Duo CPU E7500 2.93GHz, ОЗУ 2 ГБ)
Обработку, скорее всего, можно и оптимизировать, эта скорее как пример на данный момент.
Может, и XML будет быстрее парсить как текстовик…
(8) cool.vlad4,
>А чем отличается от ?
Посмотрел ради интереса, да абсолютно всем отличается! Код даже близко рядом не стоял, а что касается структуры архива — дык это мелкосфот придумал, а не мы с Василием.
И уж никогда бы мне в голову не пришло
Испокон веков я делаю такие массивы так:
Стр=»ABCDEFGHIJKLMNOPQRSTUVWXYZ»;
(11) А я бывало и так
Интересно
Скоро мы все перейдем на XML общение ))
И даже между собой исключительно по родительским узлам будем общаться)))
(0) Заметил, что не всегда экселевский файл читается корректно при помощи этого метода (колонки читаются не в том порядке, в котором они расположены в экселе, и некоторые значения ячеек читаются неправильно), в чем причина я понять так и не смог (заметил лишь только то, что если его содержимое скопировать в новый файл — то все читается нормально), скорее всего имеется какая то заморочка с преобразованием эксель файла в XML формат, потому что при помощи COM файл читается нормально (если интересно, то приложил этот эксель файл к сообщению). Вот такая вот загагулина.
(15) Zigfridish,
я это тоже заметил, но пока особо не разбирался. Обработка абсолютно прозрачная, с комментами, может кто и найдет, где собака порылась;) Будет время — сам еще внимательно попроверяю
(10) 7 секунд это круто
Спасибо за обработку))в добавку:
1. файлы OpenOffice таблицы формата .ods открываются таким же способом только естественно файл с данными xml другой))(вроде и .odt так же, но не проверял).
Спасибо! Все было в свое время заточено под *.xls но потом с переходом на *.xlsx пришлось всех оставлять на 2003, а тут всех обрадуем 😉 еще раз спасибо!
Хорошо что стал поддерживать *.xlsx. Спасибо
(20)Честное слово, это не я! :))))) Это мелкософт поддерживает
(21) ладно, Microsoft`у тоже спасибо))
Классно придумано. Да и на другие статьи автора обращу внимание, интересные вещи пишет. Молодец!
Кстати, если в файле нет ни одной ячейки со строками
файл sharedStrings.xml не создается
и обработка валится с ошибкой.
стоит добавить проверку
Процедура ПарсингSharedStrings()
XML=Новый ЧтениеXML;
//Добавлено: maxval 03.07.2012
Имя = Объект.ВременнаяПапка+»sharedStrings.xml»;
Ф = новый Файл(Имя);
Если Не ф.Существует() Тогда
Возврат;
КонецЕсли;
XML.ОткрытьФайл(Имя);
/// maxval 03.07.2012
реализовал все те же принципы под Управляемые формы, в.т.ч. Веб-клиент:
(24) 1cmax,
Ага, я как-то поленился проверить…
(15) Zigfridish, Аналогичную багу нашел.. эх.. сначала думал что для любого сервака универсальное решение. а то серваки на линуксе. там никаких ком объектов…
Как раз что скинули файл для загрузки в xsls. Как будет возможность сразу скачаю. Спасибо за полезную обработку.
(21)
Честное слово, это не я! :))))) Это мелкософт поддерживает
говорят он уже пожалел об этом
—
в следующем офисе вроде грозятся зделать бинарный закрытый формат
🙂
(0) небольшой косячок… в блоке
МассивСтрок д.б. именно массивом, а не списком значений, иначе при получении значения из ячейки со строкой имеем тип «ЭлементСпискаЗначений», а не «Строка».
Визуально в табличном поле этого не видно, но при работе с получившейся таблицей могут быть неожиданности.
(15) А где в Вашем файле получаются неправильные значения при чтении обработкой? А то файл немаленький — визуально очень сложно заметить. Мне нужно понять, насколько это критично для моей задачи.
(31)Блин, ну код же открытый. Мне она без надобности, к старому я не возвращаюсь;)
(32) Да не, вопросов нет… За код спасибо! Это я написал для тех, кто будет использовать. 😉
(33) Spartan, я просто не заметил сгоряча, что (31) не мне :)))
(15),(31) Все, увидел… посмотрел сегодня на свежую голову.
P.S. Нашел в чем косяк — сейчас разбираюсь как победить. Получается неверный массив строк из файла sharedStrings.xml, если в нем присутствуют пустые строки.
(0),(15),(27) Как-то так, видимо:
Показать
(36) Spartan, не недостаточно, когда несколько листов, неверно определяет.
Обработка замечательная!!! Спасибо огромнющее за нее!
Только вот не пойму, на одном файле нормально работает, а на другом выдает ошибку
ТЗ[НомерСтроки-1][НомерКолонки-1]=Значение;
Помогите, пожалуйста, разобраться.
(к сообщению прикреплены файлы — на «Книга2» — работает, а на «Книга1» — выдает ошибку)… Вроде ничем таким особым файлы не различаются??? Не могу понять…
(38) ответ найден, смотрите приложенные мной скриншоты — временные файлы,
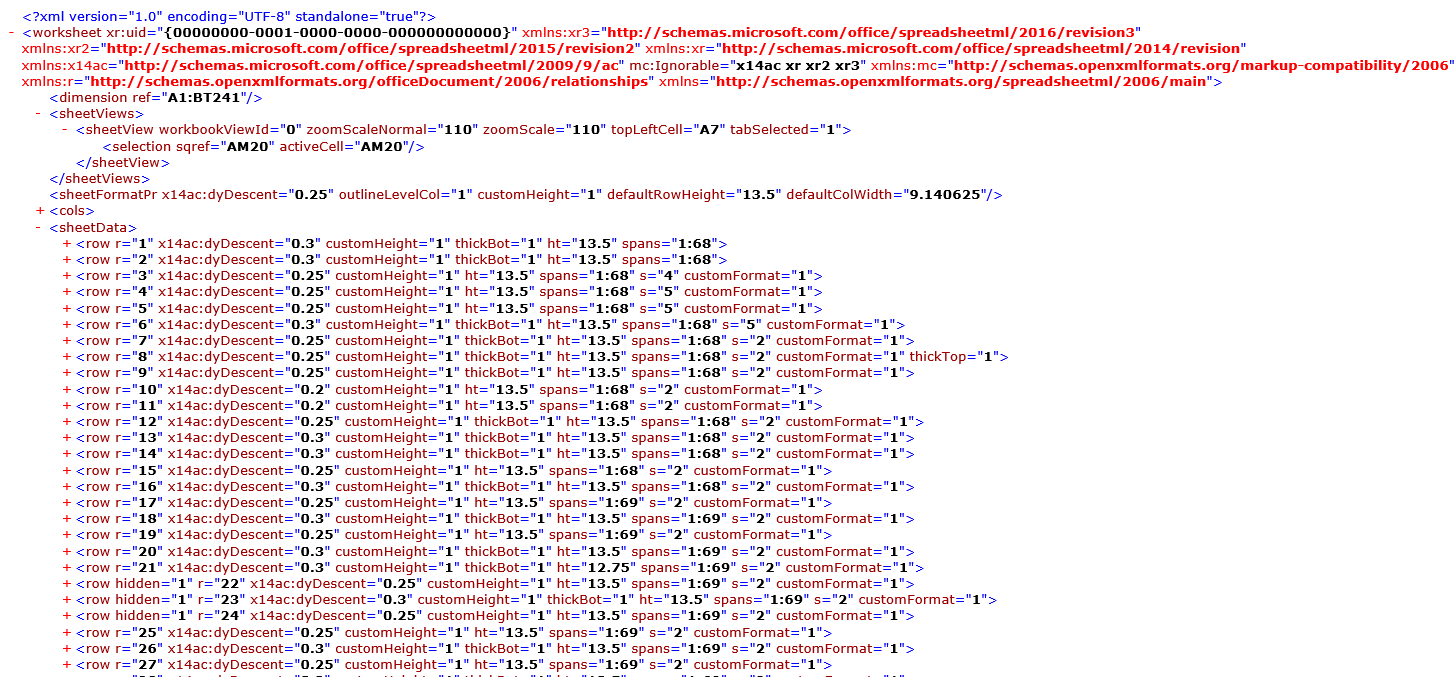
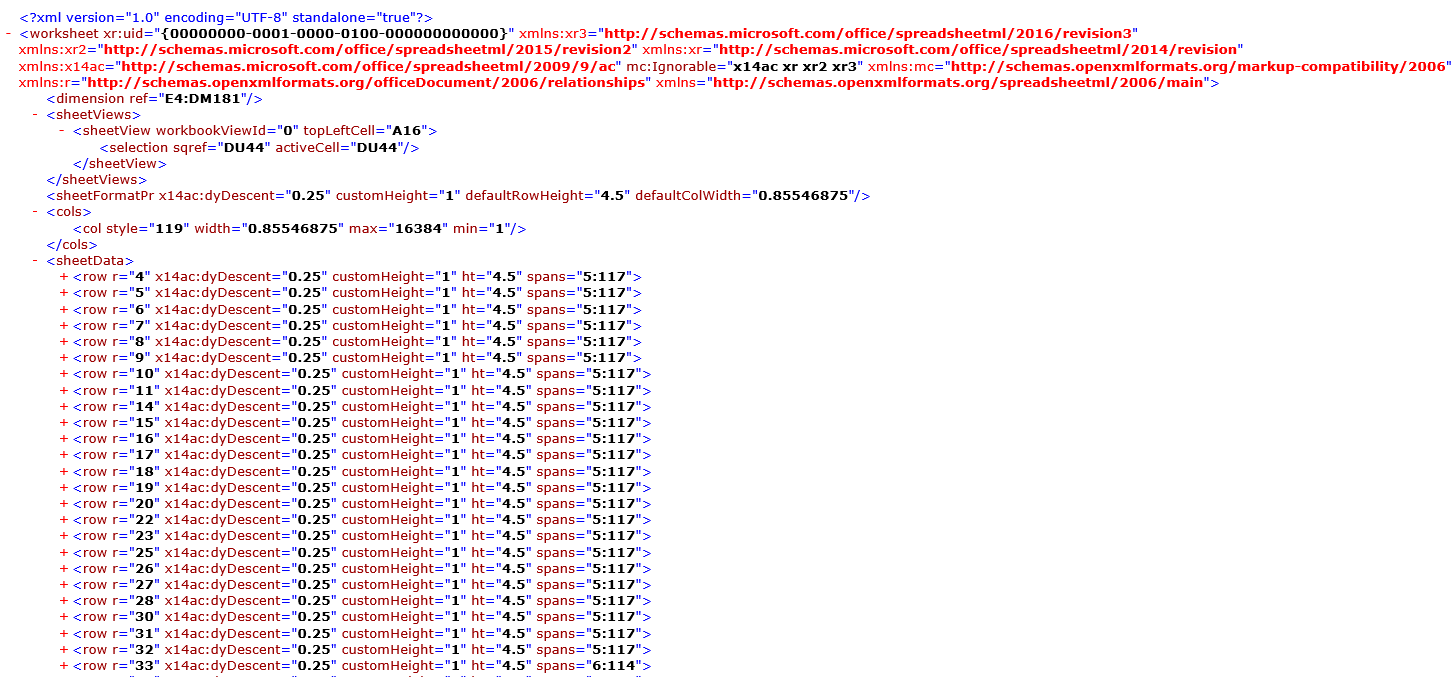
вот этот лист загружается успешно
а на следующем скриншоте нумерация строк начинается не с единицы, что ведет к рассинхронизации номеров строк файла и таблизы значений 1с,
и он не загружается потому что в таблице значений количество строк соответствует количеству строк файла, но обращение к строке таблицы значений 1с идет по номеру строки файла который не соответствует номеру строки заведенному в 1с. Надо вводить уточнять нумерацию для соответствия между файлом и таблицей значений.
(38) вот такая доработка (исправление) парсит файл правильно
Показать
Спасибо автору за легкий код! Очень хорошая обработка! Я еще добавил в нее номера строк и колонок вот так, процедуру ТЗИПриПолученииДанных надо подключить через обработчик события табличного поля:
Показать
и уменьшил ширину колонок в которых ни в одной строке нет данных
(16) колонки перепутаны потому что колонки создаются не единовременно в порядке определеном в файе но иначе, по мере обнаружения заполненных значений ячеек при сканировании листа процедурой ПарсингSheet.
В данном случае помогло бы предварительое скаирование для определения кол-ва строк и колонок в файле (или м.б. считывание этих значений из полей файла), затем создание колонок и второй проход по файлу парсером уже с заполнением ТЗ для сохранения правилього порядка. Если много пустых их можно удалить позже.
Простейшим способом упорядочения колонок будут заголовки колонок на исходном импортируемом листе.
(42) Вот программная реализация удаления путаницы и упорядочения колонок
Показать